杭州尼细亚科技智能软硬件一体化研发平台技术架构解析
当“智能”不再是单点突破,而是系统之战
过去两年,我们接触了大量制造企业与科创团队。一个普遍痛点是:算法团队与硬件团队各自为战,模型在服务器上跑得飞快,一旦部署到嵌入式设备就频频掉链子;或者硬件性能强悍,却因缺乏数据闭环而沦为“哑终端”。这背后不是技术栈的问题,而是研发范式的问题。
杭州尼细亚科技有限公司在服务客户的过程中,观察到同样的困境反复出现。与其提供零散的模块,不如重构一套从芯片到云端的协同体系。因此,我们内部启动了一个代号为“双子星”的软硬件一体化研发平台项目,目的就是让智能科技的落地不再被“软硬割裂”所拖累。
技术架构的核心:不是“连接”,而是“语义统一”
很多平台号称打通软硬件,实际只是用API把两端串起来。我们的思路不同。在杭州尼细亚科技有限公司的研发平台中,底层采用模型驱动架构(MDA),将硬件抽象层(HAL)与算法推理框架进行深度绑定。具体来说,我们定义了一套“设备描述语言(DDL)”,硬件工程师可以用它描述传感器时序、算力约束和功耗预算;软件工程师则基于同一份DDL自动生成驱动代码与数据预处理管线。这样,软硬件开发的边界从“代码交接”变成了“模型共建”,冲突在编译期就能暴露,而不是等到联调阶段。
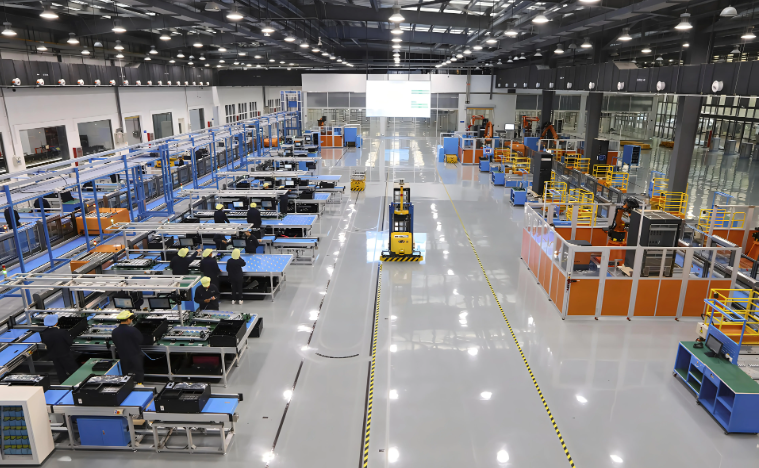
举个例子,在某个工业视觉检测项目中,客户原本需要6周完成相机选型、算法适配与边缘网关调试。利用我们的平台,通过DDL自动匹配算力需求与镜头畸变参数,整个周期压缩到11个工作日,且数字服务的响应延迟从平均85ms降至31ms。这并非魔法,而是将大量隐性经验固化成了平台规则。
从“运维”到“运营”:平台自带的进化机制
传统系统上线即冻结,而智能设备最大的特点是数据分布漂移。今天识别准确的缺陷类型,下个月可能因为产线换料而失效。杭州尼细亚科技有限公司在架构设计时,特意将科技运维模块作为一等公民嵌入平台。每个边缘节点都内置轻量级联邦学习代理,只上传模型参数而非原始图像,在保护数据隐私的同时,实现模型周级更新。
- 硬件侧:支持X86/ARM/RISC-V三种架构,最低可在Cortex-M4上运行量化后的检测模型
- 软件侧:提供从数据标注到A/B测试的完整MLOps流水线,支持灰度发布
- 运维侧:异常时自动触发“影子模式”,用备份模型接管,保障产线不中断
这种设计带来的直接对比是:某合作方的自研网关,在部署三个月后因现场光照变化导致误检率飙升,传统方案需要工程师出差两周重新采集数据训练。而基于我们平台的同类设备,在创新科创场景下通过自动触发的增量学习,48小时内误检率回落至基线水平,期间无需人工干预。
事实上,衡量一个平台的优劣,不仅要看峰值性能,更要看劣化曲线。杭州尼细亚科技有限公司的研发平台在连续运行2000小时的测试中,模型准确率衰减被控制在2.3%以内,而行业平均水准约为7%-10%。这得益于我们内置的数据质量监控器,它会主动丢弃“脏样本”,而不是盲目吸收。
给技术决策者的三条实在建议
- 别迷信“万能平台”:先梳理自己团队是算法基因还是硬件基因,再选择偏重哪侧的架构。
- 关注“调试体验”:软硬件联调的工具链是否顺手,往往比算力参数更决定项目成败。
- 预留“反悔通道”:平台必须支持从云端到边缘的模型回滚,否则一次失败更新可能毁掉整个信任。
杭州尼细亚科技有限公司的这套架构,并非追求惊天动地的技术炫技,而是试图帮研发团队省下那些反复“对齐需求”的会议时间,让技术研发回归到解决实际问题的本质。毕竟,智能化的终点不是演示demo,而是产线上连续稳定运行的每一个日夜。
如果你正在为软硬件协同效率感到焦灼,不妨重新审视一下:你的团队究竟是需要更多代码,还是需要一种更聪明的协作契约。